Wofür das Schwärzen gedacht ist
Ein schwarzer Balken über Text, der darunter weiter im Dokument steht, schützt nichts. Diese Seite entfernt den Text selbst. Das Anzeigen der Treffer ist kostenlos, das Erstellen der geschwärzten Kopie ist Premium. Das Original bleibt immer unverändert, es entsteht eine neue Datei mit dem Zusatz „_geschwärzt“.
Unterstützt werden PDF sowie DOCX, XLSX und PPTX (und die Makro-Varianten).
Der Ablauf
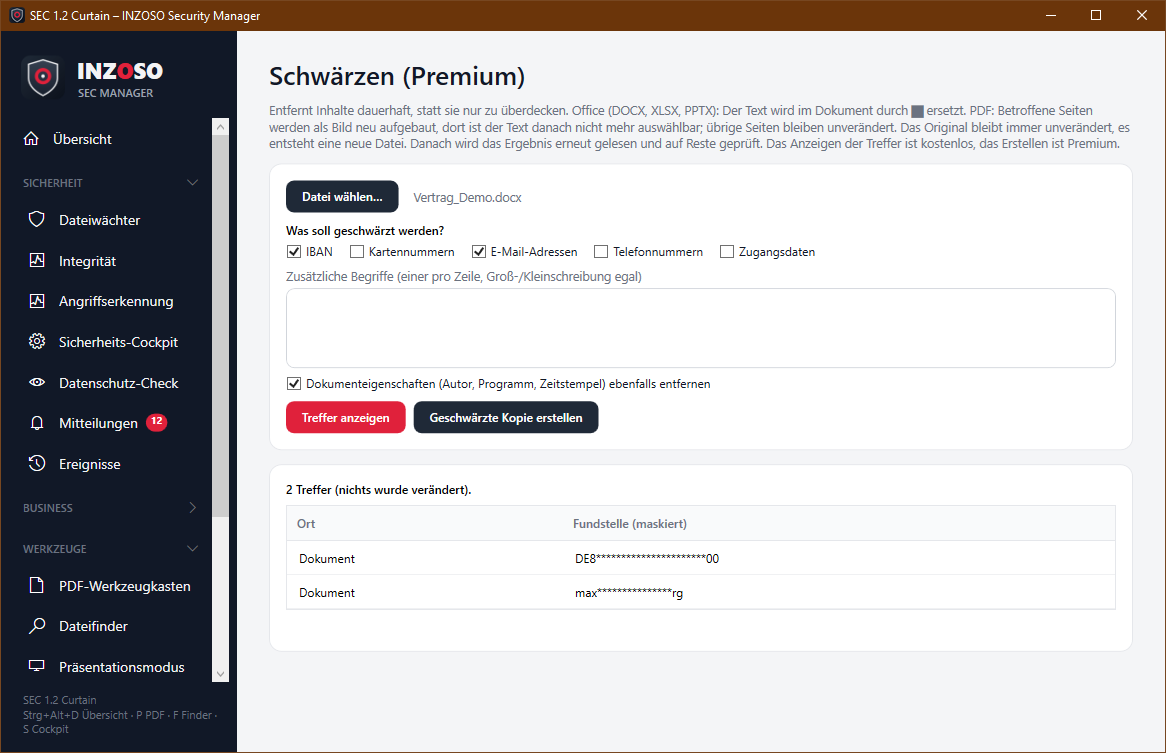
- Datei wählen.
- Auswählen, was geschwärzt werden soll: IBAN, Kartennummern, E-Mail-Adressen, Telefonnummern, Zugangsdaten und/oder eigene Begriffe (einer pro Zeile, Groß-/Kleinschreibung egal). IBAN und Kartennummern werden mit Prüfsumme geprüft, damit zufällige Zahlen nicht getroffen werden.
- Treffer anzeigen: zeigt Ort (Seite, Folie, Teil) und maskierte Fundstelle. Es wird nichts verändert.
- Geschwärzte Kopie erstellen (Premium). Auf Wunsch werden zugleich die Dokumenteigenschaften (Autor, Programm, Zeitstempel) entfernt.
- Das Programm liest das Ergebnis erneut und meldet, ob etwas übrig geblieben ist.
So wird geschwärzt
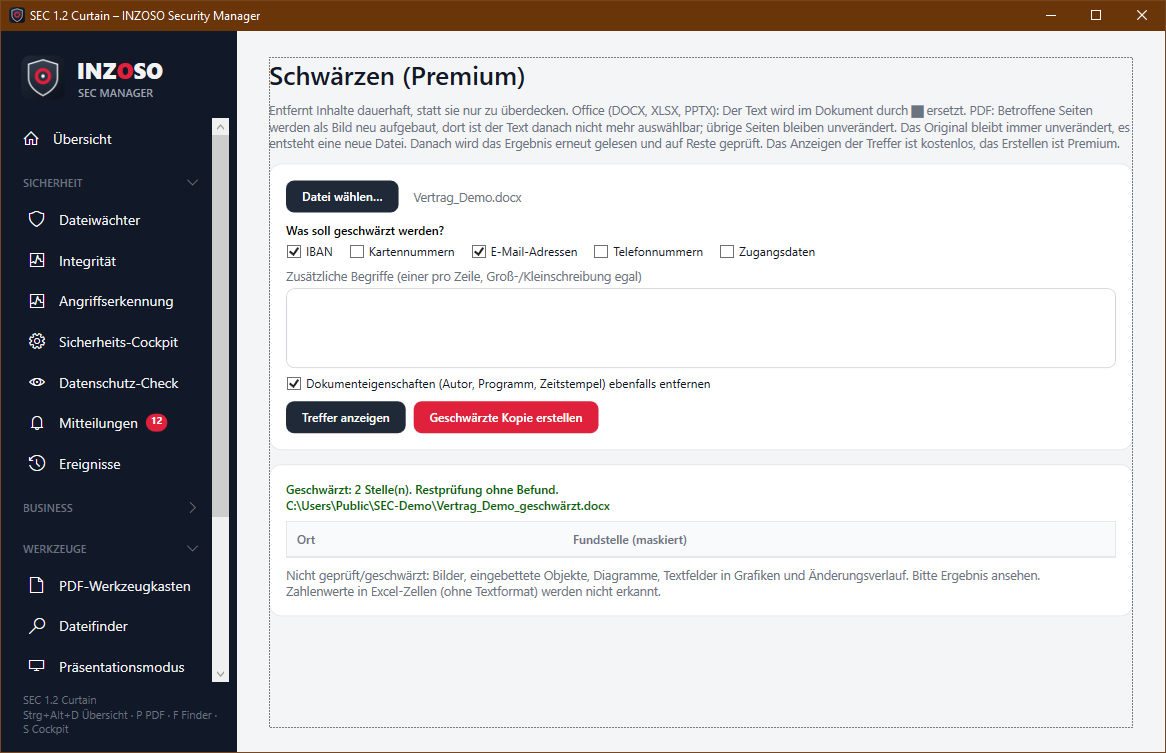
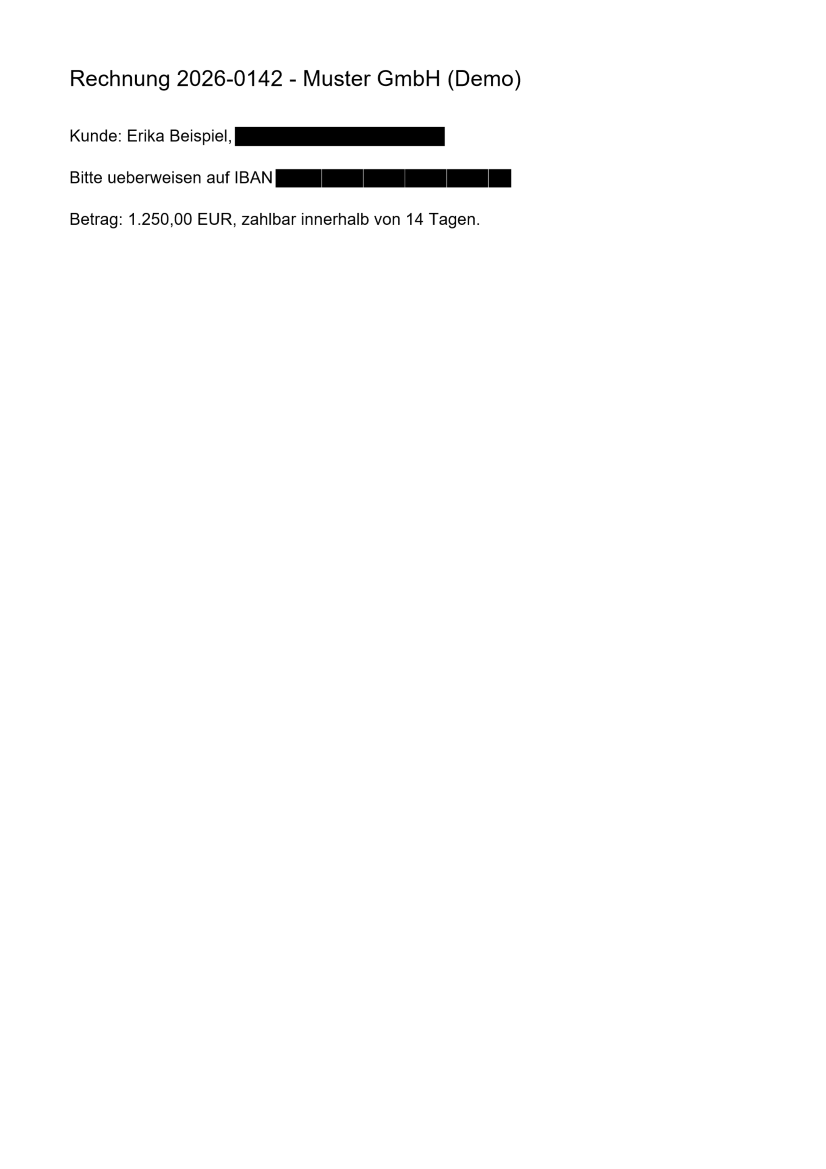
- Office: Die Zeichen im Text des Dokuments (Hauptteil, Kopf-/Fußzeilen, Fußnoten, Kommentare, Folien, Notizen, Tabellen-Texte) werden durch █ ersetzt, auch wenn ein Wert über mehrere Textabschnitte verteilt ist.
- PDF: Seiten mit Treffern werden als Bild neu aufgebaut, die Treffer sind darin schwarz. Der Text dieser Seiten ist danach nicht mehr auswählbar oder durchsuchbar. Seiten ohne Treffer bleiben unverändert.
Restprüfung
- PDF: Betroffene Seiten dürfen keine Textebene mehr haben; der gesamte Text wird erneut auf die gewählten Begriffe geprüft.
- Office: Der Text wird erneut geprüft. Zusätzlich werden alle XML-Teile (zum Beispiel Links, Eigenschaften) nach den ersetzten Werten durchsucht. Findet sich dort noch ein Wert, steht das in der Meldung, und die Datei sollte nicht weitergegeben werden.
Gescannte PDFs und Texterkennung
Gescannte PDFs haben keine Textebene. Mit eingeschalteter Texterkennung (Standard; nutzt die in Windows enthaltene Erkennung, nur lokal) werden solche Seiten gelesen, geschwärzt und das Ergebnis erneut per Texterkennung kontrolliert. Auch der Datenschutz-Check und der Dateifinder können gescannte PDFs so lesen.
- Voraussetzung: In den Windows-Einstellungen unter Zeit und Sprache › Sprache ist bei Deutsch die „Texterkennung“ installiert.
- Die Erkennung kann Zeichen verwechseln (zum Beispiel 0 und O). Bei IBAN und Kartenzahlen gleicht das Programm das aus, ein Rest an Fehlern bleibt möglich.
- Bilddateien und Bilder innerhalb von Dokumenten werden nicht gelesen.
Grenzen, die Sie kennen sollten
- Bilder, eingebettete Objekte, Diagramme und der Änderungsverlauf in Office-Dateien werden nicht bearbeitet. Zahlenwerte in Excel-Zellen ohne Textformat werden nicht erkannt.
- PDF: Geschwärzt wird wortweise, der Balken deckt ganze Wörter ab. Gedrehte Seiten und Seiten mit Beschnittrahmen werden abgelehnt. Lesezeichen, Formularfelder und Anhänge der geschwärzten Seiten entfallen. Passwortgeschützte PDFs lassen sich nicht bearbeiten.
- Die Erkennung ist musterbasiert. Prüfen Sie die Kopie vor der Weitergabe selbst, vor allem bei vertraulichen Inhalten.